Text=多田 誠治(日本IBM)、川向 智之(日本アイ・ビー・エム・システムズ・エンジニアリング)
生成AIの活用は、この2〜3年で大きく段階を変えてきた。社内文書を検索して回答を返すAIアシスタント型から、定型業務を自動化するAIワークフロー型へ、そして与えられた役割とゴールをもとにワークフロー自体を動的に設計し、人間の介入なしにタスクを実行する自律駆動型のAIエージェントへと進んでいる。
一方で、AIエージェントの企業導入が思うように進まないという声も多く聞く。理由はガバナンスや体制など多岐にわたるが、我々がデータの観点から向き合うべき課題と考えているのは、AIエージェントが企業のデータを使えないという一点である。
観察し、状況を判断し、意思決定を下して行動するという振る舞い自体は、AIに与えることができる。しかしそれぞれの振る舞いの中で、どのデータを見るべきなのかをAIは知らない。
企業のデータがどこにあって、それがどういう意味を持つのか、そして特定の業務文脈における判断において何を参照すべきなのか——これらが与えられていないのである。
本稿では、この課題に答える形で、AIエージェントに与えるべきコンテキストを2つに整理し、それぞれが何を担うのかを示していく。
なお、この領域の用語や分類は業界でまだ確立されていない。本稿で用いるものは、我々が実務の中で整理した現時点での呼び方であり、定義が固まっていく過程で変わりうることを了解してほしい。
AIエージェントが
データを使えないという問題
人間が業務を行うとき、我々は何らかの事象を観察し、状況を判断し、意思決定を下して行動に移す。この流れの下側には、常にデータがある。
そのとき人間は、目にしているデータが業務上何を意味し、どこから来て、どれくらい新しいのかを踏まえている。そして、ある状況では販売実績を見て、別の状況では過去の同種案件の記録を見る。どの局面でどのデータを見るべきかを、経験として知っている。
AIエージェントに欠けているのは、まさにこの部分である。必要なものは2つに分けられる。1つはデータそのものが持つ文脈——そのデータが業務上何を意味し、どこで生まれ、どのチームが所有し、いまどれだけ新しいのか——である。もう1つは、特定の業務文脈において、どのデータをどう使うべきかという文脈である。
この違いは、カーナビゲーションのアナロジーで考えるとわかりやすい(図表1)。
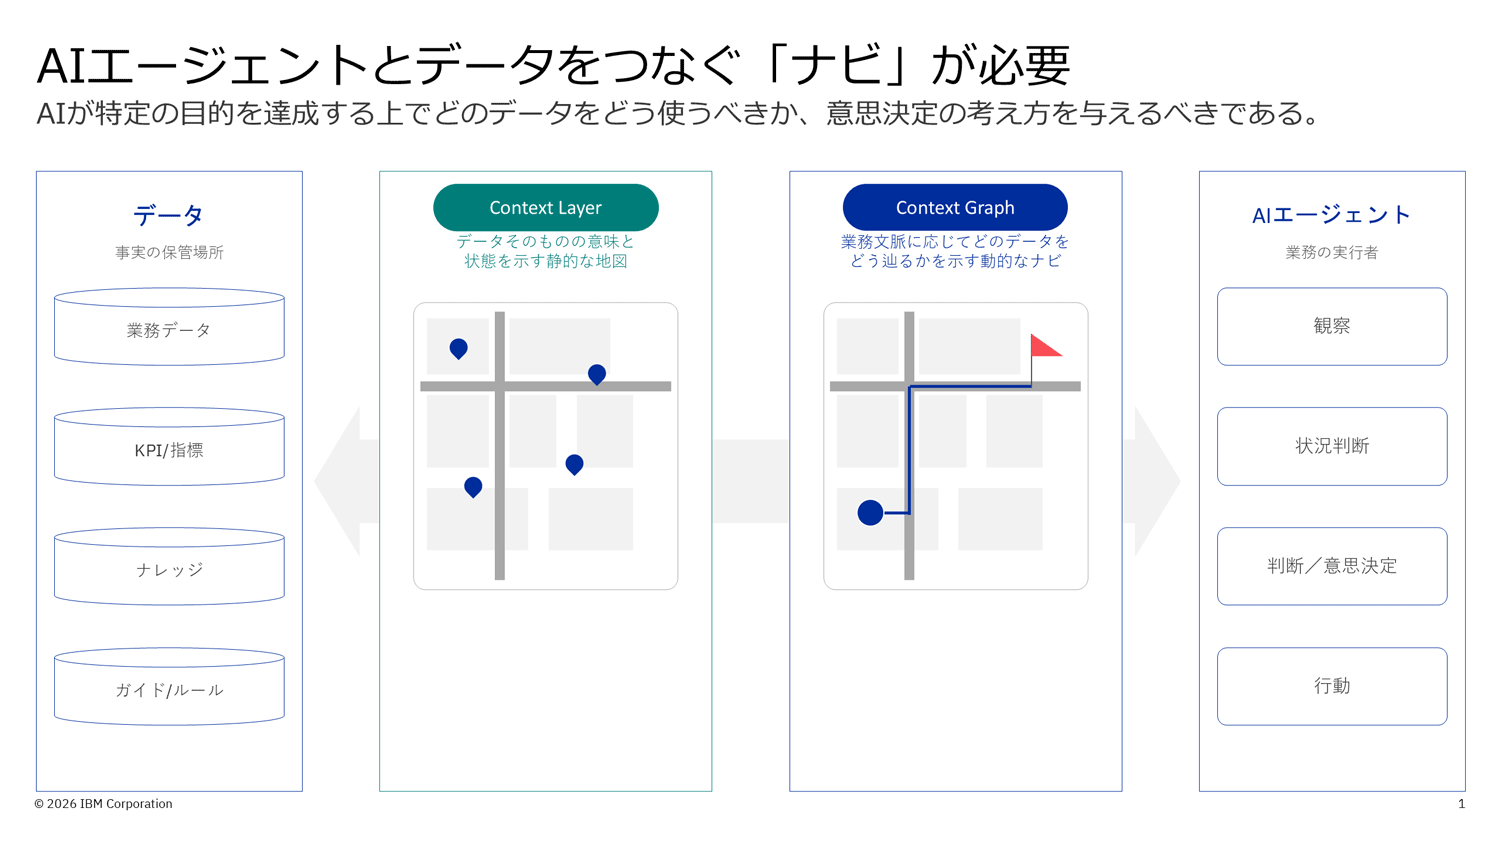
前者、すなわちデータそのものが持つ文脈は地図にあたる。企業の中にどんなデータがどこにあり、それが何を表し、それらがどうつながっているのか。建物の位置だけでなく、その建物が何の施設で誰が管理しているのか、そして地図自体がいつ時点のものかまでが書き込まれた地図である。
しかし、地図があるだけでは足りない。現在地が東京で、大阪に向かいたいとする。この目的地は決まっていても、高速道路を使うのか下道を使うのか、どの走行ルートを辿ればよいのかは、地図だけからは決まらない。到着を急ぐのか費用を抑えるのかという判断基準次第で、選ぶべき経路は変わる。データの地図が手に入ったところで、そこに加えてナビゲーションが必要になる。これが後者、すなわち特定の業務文脈においてどのデータをどう使うべきか、に相当する。
本稿ではこの2つを、Context Layer(コンテキスト・レイヤー)とContext Graph(コンテキスト・グラフ)と呼ぶ。前者はデータそのものの意味と状態を示す静的な地図であり、後者は業務文脈に応じてどのデータをどう辿るかを示す動的なナビである。
意味に基づく
データアクセスを解決する層
まず、地図の側から見ていく。
AIエージェントが企業データを正しく利用するうえで最初の壁になるのは、データの業務上の意味をAIが理解できないことである。
わかりやすい失敗の形は、AIに直接データへのアクセス方法、すなわちSQLを組み立てさせるやり方である。単純な問い合わせであれば、AIは妥当なSQLを生成する。しかし実際の業務に当てはめると、そうはいかない場面が次々に出てくる。
たとえば、売上金額は税込みなのか税抜きなのか。製品の不良率を計算するとき、単純平均で出すのか加重平均で出すのか。重大アラートを出す閾値は何パーセントなのか。
これらは企業固有のビジネスロジックやルールであり、AIが一般的な学習から知っているものではない。知らないまま、DBの構造や列の名称から意味を推測してSQLを組み立てるため、業務定義と整合しない結果が返る。これがハルシネーションとして現れる。
つまりハルシネーションの原因は、モデルの性能ではなく、企業固有の意味定義が機械可読な形で与えられていないことにある。したがって解決の方向は、より優れたモデルを探すことではない。人間が先にデータの意味を明示的に定義し、それを物理的なデータアクセスにマッピングしておくことである。
こうすることで役割が分かれる。正しいデータに正しくアクセスするという決定論的な部分は意味定義の層が担い、AIエージェントは関係性を見てどのデータをどう探すかを考える推論の側に注力する。AIに意味を推測させないことが要点である。
本稿ではContext Layerを、推論・実行時に、データの意味に基づく決定論的なデータアクセスを解決する層と位置づける。Context Layerは、これを担う次の3つの要素で構成される(図表2)。
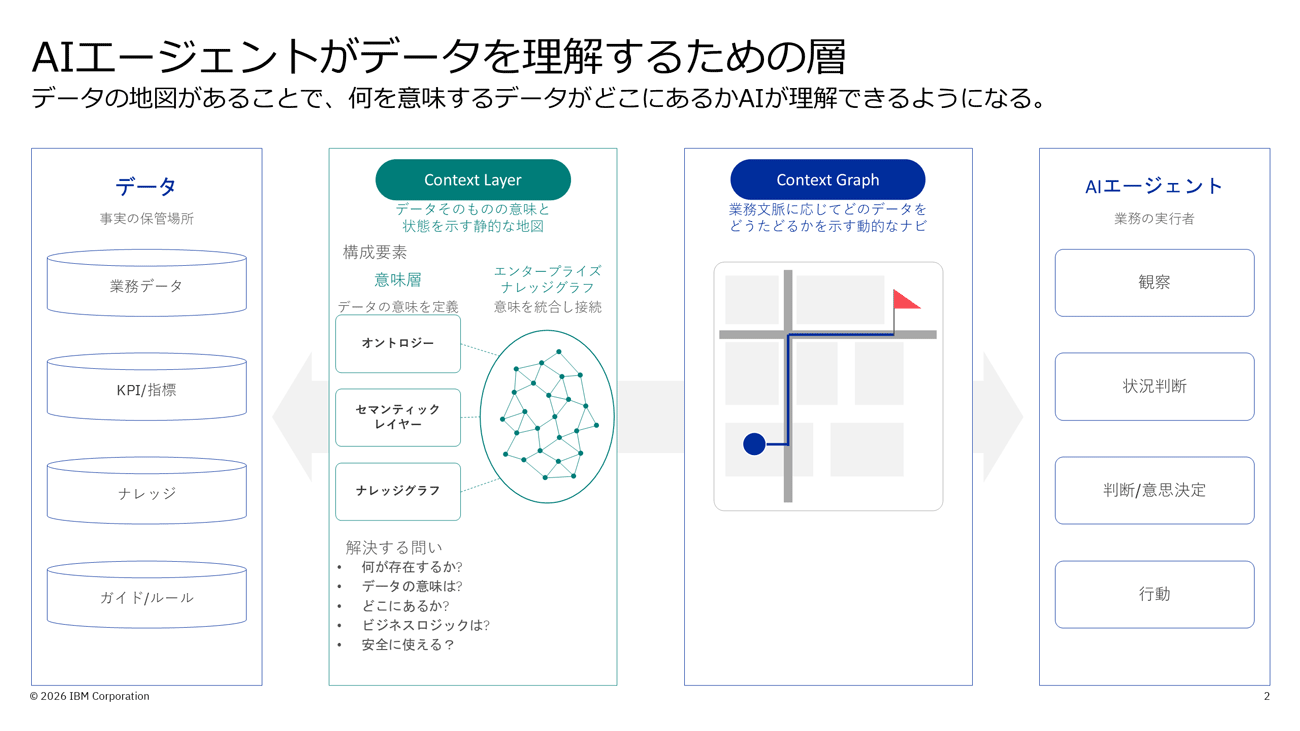
オントロジーは、人間が暗黙的に理解している業務知識や概念間の関係を、明示的かつAIが読める形で構造化する。顧客・商品・契約・注文といったエンティティーと、その間の関係性が対象となる。
セマンティック・レイヤーは、企業データの指標や集計ルールを統一的に定義し、データへのアクセスにマッピングする。メジャー、ディメンション、集計ルール、KPI、結合の定義などが対象である。先の加重平均の例であれば、その計算ロジックをここに定義しておくことで、AIは定義済みのビジネスロジックを使って問い合わせを組み立てられる。
ナレッジグラフは、非構造化データに含まれる業務知識の関係性を表現する。文書から人・機能・用語・ルールといったエンティティーとその関係性を抽出し、グラフとして保持する。ここでのナレッジグラフは、個々のドメインの文書群が持つ意味の表現を指す。
重要なのは、これら3つがいずれも推論時に機械可読であることだ。後付けの資料やドキュメントとして人間向けに整備されているだけでは、AIエージェントの実行時には役に立たない。
これらの要素は多くの場合、ドメイン(業務領域)ごとに整備される。ドメインを横断して接続し、企業全体で意味の解決を担う統合層としたものを、本稿では「エンタープライズナレッジグラフ」と呼ぶ。
Context Layerの拡張(Extension)にあたり、ある顧客に関する契約・サポート履歴・関連文書について領域をまたいで辿るといった、単一ドメインでは閉じない問いの解決はこの層が受け持つ。
なおデータガバナンス——メタデータ管理、品質維持、所有者(オーナーシップ)、アクセス制御、監査性・追跡可能性——は、この層に隣接する不可欠な仕組みだが、本稿では Context Layerの構成要素には含めない。
ガバナンスの整備・運用は推論・実行時に閉じない継続的な営みであり、この層の役割である推論・実行時の決定論的なアクセス解決とは時間軸が異なるためである。推論時には、その成果である権限・ポリシー・品質の情報が参照される、という関係にある。
なお非構造化データについては、文書を細かく分割して類似度で検索する従来型RAGの限界——チャンク間および文書全体との関係性が損なわれ、業務的な依存関係や因果関係を扱えない——が別途大きな論点になる。
ナレッジグラフを用いてエンティティーの関係をたどるGraphRAGが有効だが、これはベクトル類似検索を置き換えるのではなく併用するものである。詳細は本稿の範囲を超えるため、ここでは「エンティティーと関係性を構造化して持つ」という要点のみを押さえておく。
意思決定の文脈を
どうデータ化するか
データの地図があることで、何がどこにあり、それが何を意味するかは理解できるようになる。しかしそれだけでは、自律的な判断には届かない。加えて必要なのは、判断材料をどうやって集めて、なぜその判断が妥当と考えられるのかを説明できる能力である。
ここで登場するのがContext Graphである。本稿では、特定の業務目的のために必要な知識だけを束ねた、つながりを持つ知識のビューと定義する。組織に蓄積された知識、業務システムの現在値、そしてその業務固有の情報を、目的に合わせて集めたものである。
企業の全データを1つの巨大なグラフにすることではない。調達先の選定のためのContext Graphと、製造ラインの品質改善のためのContext Graphは、同じ企業データを土台にしても別の形になる。
データソースから意味の層を経て、エンタープライズナレッジグラフとして統合された知識の土台があり、その上に目的別のビューとしてContext Graphが切り出され、AIエージェントに供給される——という全体の位置関係を先に俯瞰しておく(図表3)。
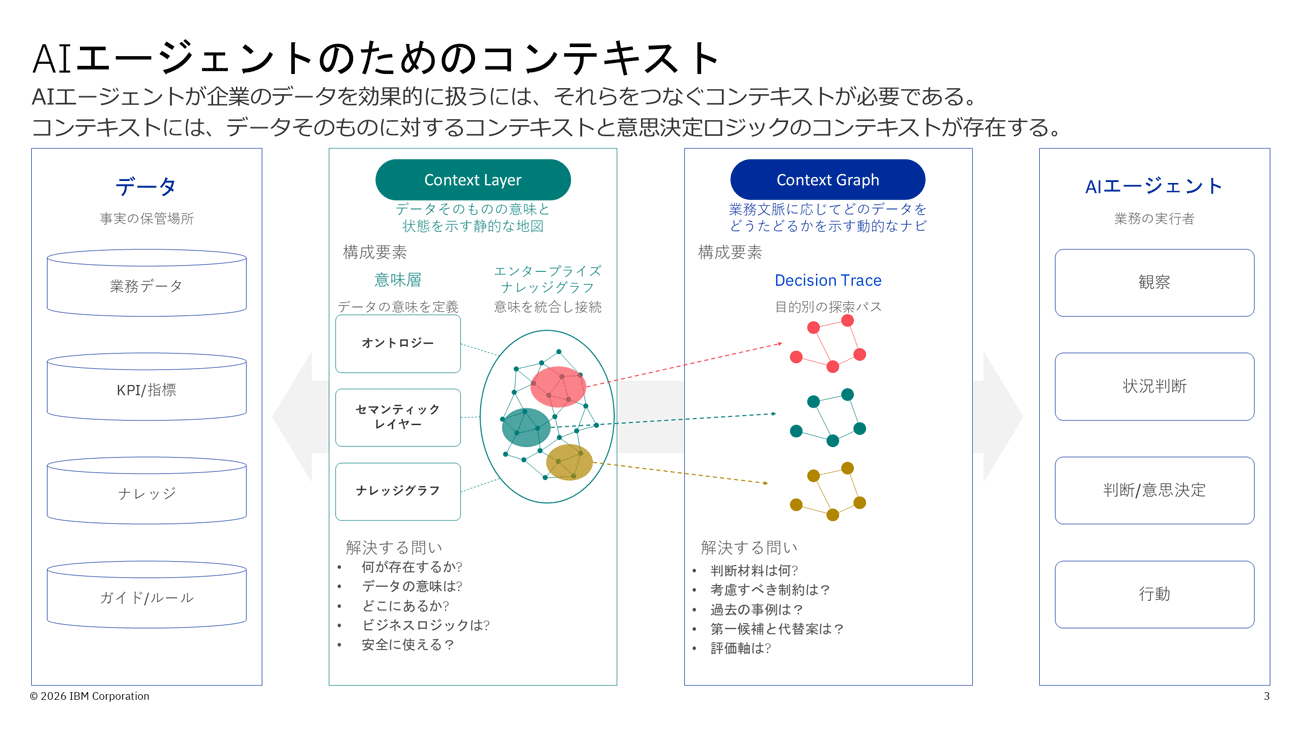
Context Graphを構成する3系統のうち、組織に蓄積された知識と業務システムの現在値は、前述した層から供給される。残る業務固有の情報の中核に置く要素を、本稿ではDecision Trace(意思決定の軌跡)と呼ぶ。
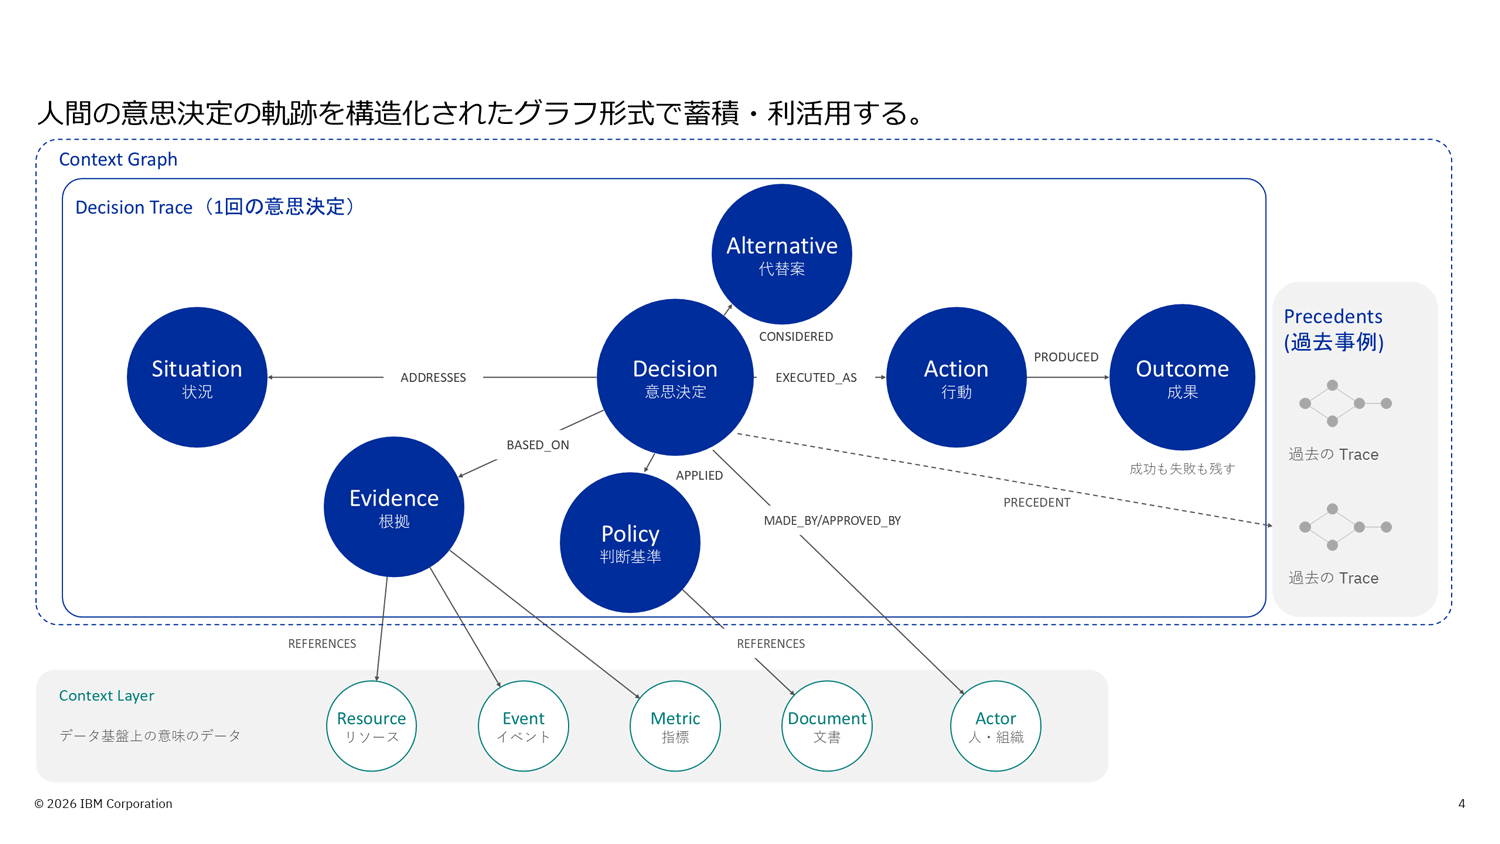
走行ルートの履歴から、この意思決定においてどんなデータをどう辿ればよいのかをAIに伝えるという発想である。これまで組織の中に埋もれていた人間の意思決定の軌跡を、構造化されたグラフデータにする。1回の意思決定が1つのTraceになり、後述する各要素がノード、要素間のつながりや過去の判断・既存の知識への参照がエッジとなる(図表4)。
人間の業務に沿って、その構成要素を見ていく。
まず、何らかの事象を観察する。特定のSituation(状況)である。その状況において、どんなデータが必要になるのか、判断材料としてどんな情報を引いてきたのかをEvidence(根拠)として残す。
次に、Policy(判断基準)がある。ポリシー、ルール、ガイドラインといった形で表現される判断の基準である。例として、調達先の選定において「特定の1社への発注比率は3割まで」といった基準があるとする。こうした基準も意思決定の一部として記録する。
Precedents(過去事例)は、過去に似たような状況でどんな意思決定を行ったかの記録である。
Alternative(代替案)は、今回の状況に対して出された候補である。A案・B案・C案といった複数の選択肢が挙がる。
その中から最終的に選ばれたものが、Decision(意思決定)であり、それがAction(行動)に落ちる。そしてここで終わらせないことが重要で、その意思決定がどんな成果を生んだのかをOutcome(成果)として残す。成功事例だけでなく、失敗事例も含めて残す。
あわせて、その判断を誰が下し、誰が承認したのか(Actor)も記録する。同じ状況でも立場や権限が違えば合理的な判断は分かれるものであり、先例としての重みは誰の判断かによって変わるためである。
これらをDecision Traceとして蓄積していくと、次に似た状況が来たときに、AIエージェントは「この判断ではどのデータを、どの順で参照し、どの基準に照らすべきか」を過去の軌跡から引き出せるようになる。
AIエージェントの主要なパターンであるPlan&ExecuteにCriticとLearnを加えたループに当てはめると、Traceの読み書きの対応がはっきりする(図表5)。
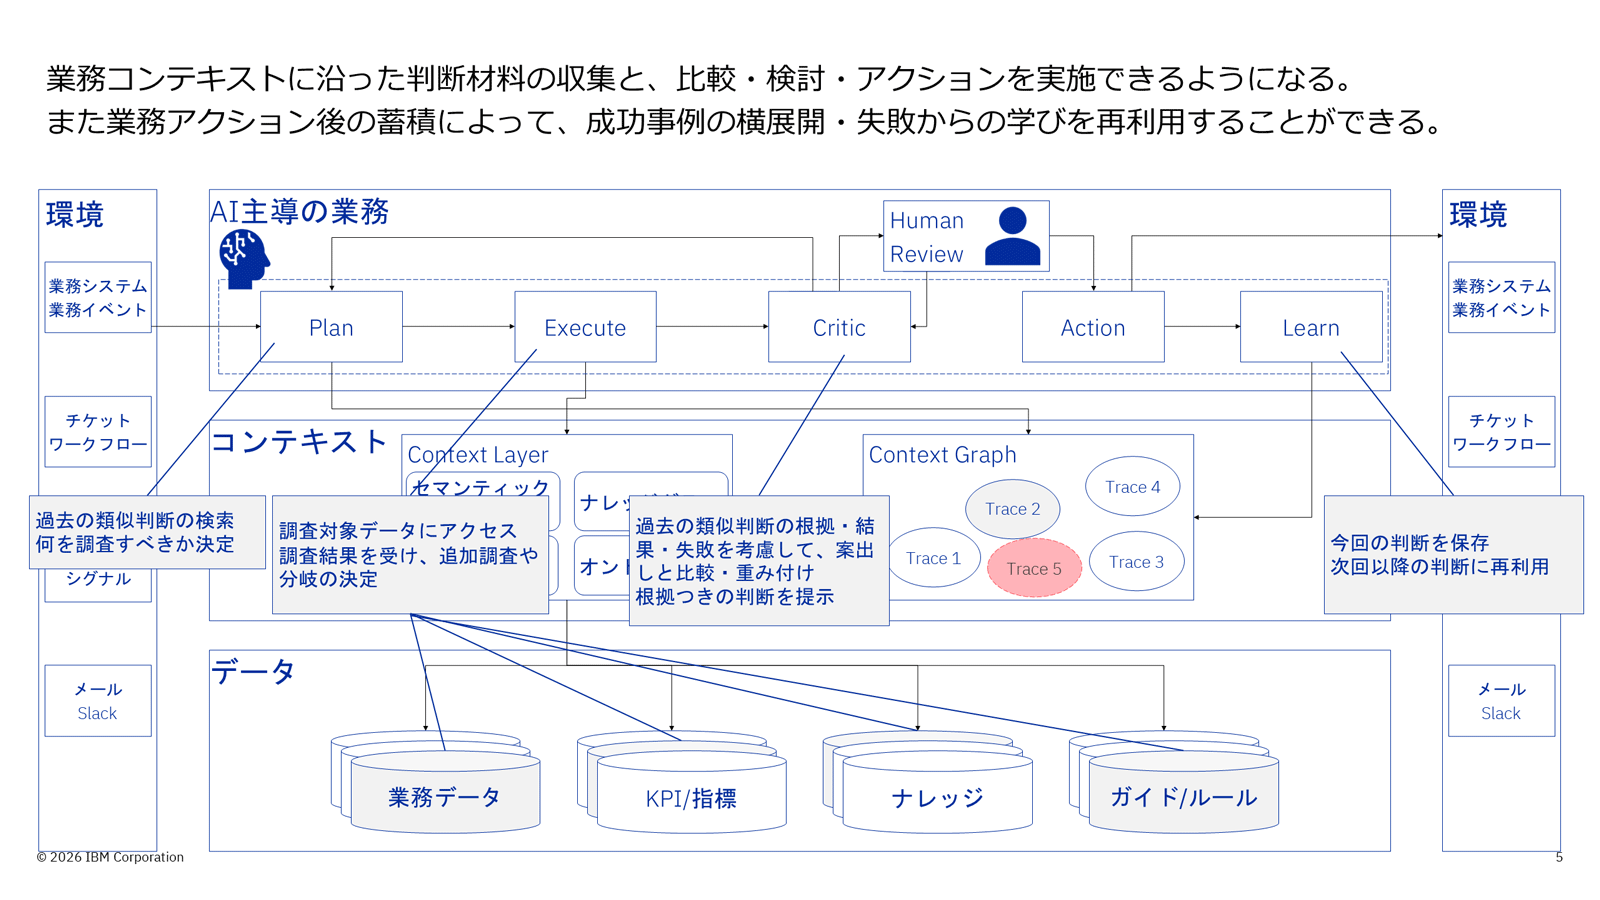
Planの段階では、現在のSituationに似たPrecedentsと適用すべきPolicyを読み、何を調査すべきかを決める。
Executeの段階では、大量のデータを総なめにするのではなく、必要なEvidenceをピンポイントで集める。
Criticの段階ではAlternativeを比較し、過去の根拠・結果・失敗を考慮した重み付けで根拠つきのDecisionを導く。
そしてLearnの段階で、今回のDecision・Action・Outcomeを新しいTraceとして書き込む。
Traceは最初から揃っているのではない。人間の意思決定の記録から始まり、エージェントが使うたびにLearnで書き足されて増えていく。このループを繰り返すことで、AIエージェントの意思決定能力は高まっていく。
Context Graphがもたらす3つの価値
Decision Traceを蓄積することは、AIを事実(What)の検索から、理由(Why)の推論へと引き上げる基盤になる。本稿では価値を3点で整理する。
1点目は、再現性・監査性と「AIの説明責任」の担保である。AIが「なぜその判断をしたのか」をホワイトボックス化できる。エージェントの思考プロセス、適用されたポリシー、参照したデータ、過去事例が記録・可視化されることで、業務上の監査性・説明性が実現する。
AIエージェントが記録システムに触れて実際に業務を動かすようになると、結果だけがあって理由がない状態は許容されなくなる。エージェントの実行連鎖を記録する層の必要性は、業界全体で急速に論じられ始めている。
2点目は、過去の類似ケースに基づく「高度な推論」の実現である。単純なキーワード検索・ベクトル検索を超える精度が得られる。過去の類似事例から成功要因と失敗要因を参照することで、手順書どおりの挙動ではなく、より自律的な判断によるアクションを導出できる。
マニュアルに書かれた手順ではなく、実際に現場で下された判断を根拠にできる点が本質的な違いである。
3点目は、Human-in-the-loopから「自律化」への移行である。人間が介入して解決した複雑な判断そのものが学習データとして蓄積される。これは言い換えれば、熟練者の頭の中にあった暗黙知が、組織の資産として形になっていくということである。
使えば使うほど組織の意思決定能力が強化され、段階的かつ安全に自律稼働へ移行していく基盤として機能する。人間のレビューを最初から外すのではなく、レビューの記録を暗黙知の記録として蓄えながら徐々に外していくという道筋である。
市場動向と今後の展望
ここまで述べてきたコンテキストという論点は、我々が独自に主張しているものではない。
2026年3月には大手調査会社のデータ分析イベントで、「コンテキストを重要なインフラストラクチャとして扱う」という論点が提示された。
そして現在は、データカタログ、グラフデータベース、データ基盤といった複数の領域のベンダーが、コンテキストの供給や意思決定の記録を扱う機能を相次いで発表しており、市場全体として、概念の提示から実装のフェーズへ移りつつある。
ただし、この市場はこれから出来上がっていく領域である。各社が実装に踏み込んでいく中で、「これは本当に合っているのか」という論点が今後当然出てくると我々は考えており、本稿で示した整理も修正されていくことを前提としている。
その前提のうえで、確度が高いと考えていることが2つある。
1つは、AIエージェントの精度は、モデルの性能ではなくコンテキストの質で決まるという構造は変わらないということ。もう1つは、コンテキストは設計して完成させるものではなく、運用しながら育てる資産だということである。
整備を終えてからAIに渡すのではなく、AIを使う中で溜まっていく判断の記録を取り込み続けることでしか、この資産は育たない。だからこそ、着手が早い組織ほど有利になる。
AIエージェントが企業のデータを使えるようにするために、まずどこから手をつけるか。本稿が、その第1歩を踏み出す一助となれば幸いである。